
全国性语料创新生态联盟成立 推动科技语料生态建设
 更新时间:2026-09-30
 浏览量:
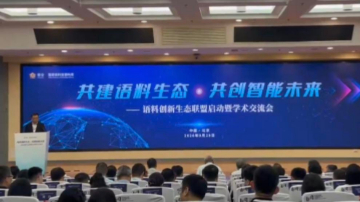
全国性语料创新生态联盟成立
9月29日,全国性语料创新生态联盟正式发起成立。联盟由中国科学院文献情报中心发起,聚焦科技语料资源建设与人工智能发展需求,探索构建更加协同的科技语料创新生态。
据了解,联盟首批共有50家共建单位,参与机构类型较为多元,涵盖国家实验室、科研院所、国家级科学数据与文献资源机构、地方政府、语料运营企业以及人工智能领域相关投资机构等。
多项语料建设成果集中发布
联盟成立当天,还集中发布了一系列语料生态建设成果,包括语料标准规范、敖仓·语料社区服务平台以及英文期刊Data Express in AI Corpus等。
这些成果从标准建设、平台服务和学术交流等不同层面切入,为科技语料资源的整理、开发和应用提供新的支撑。
以高质量科技语料夯实AI发展基础
随着人工智能技术不断发展,高质量数据和专业语料的重要性日益凸显。科技语料不仅涉及科研论文、专业文献等资源,也关系到人工智能模型训练、知识获取和应用创新等多个环节。
此次联盟将高标准、高质量科技语料建设作为核心,通过不同机构之间的协作,进一步推动优质语料资源形成规模化、规范化的发展基础。
构建跨机构跨领域协同平台
从首批共建单位的构成来看,联盟希望打通科研机构、数据资源机构、地方政府和产业主体之间的合作链条。
通过跨机构、跨领域、跨产业链协同,各参与方可以围绕科技语料开展资源共建、联合开发和创新应用,进一步提升语料资源的利用效率。
推动科技语料共建共享
此次联盟成立,旨在推动科技语料资源在更大范围内实现共建共享,并促进语料资源与人工智能技术应用之间形成更加紧密的联系。
未来,随着更多机构参与科技语料建设,相关标准、平台和资源体系有望进一步完善,为科技创新和人工智能产业发展提供更加丰富的数据与语料支撑。
文章来源:网络 文章作者:小编
上一篇 : 当网球机器人走进赛场,具身智能加速迈向现实应用
下一篇:OpenAI凌晨大上新!Dots接棒智能体,AI助手开始学会