
3万个智能体同时开工,Anthropic离AI自我改进还有多远?
 更新时间:2026-09-18
 浏览量:
如果说过去的AI主要是在帮助研究人员完成工作,那么现在,一些前沿AI公司正在尝试让智能体直接进入研发流程。
Anthropic最新公布的一组内部数据,就展示了这一变化。
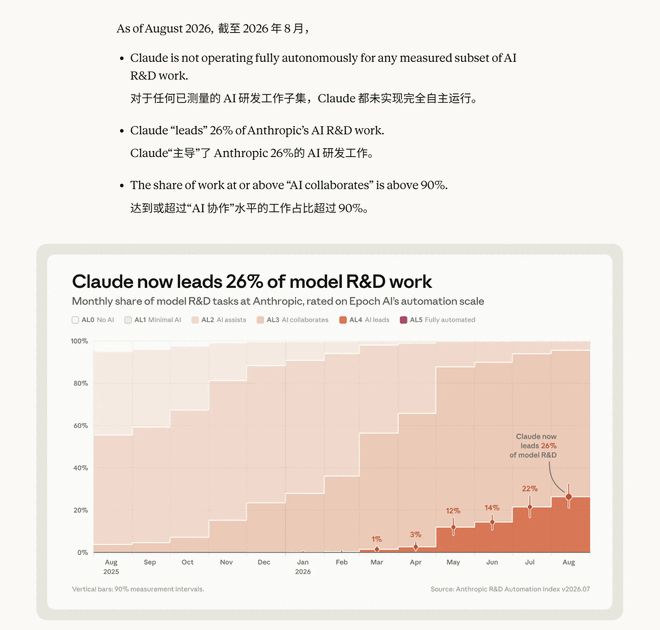
数据显示,今年2月,Claude能够“主导”的AI研发任务还不到1%,到了8月,这一比例已经上升到26%。与此同时,超过90%的研发任务至少已经进入“协作”阶段,也就是说,在人类研究人员设定目标和监督的情况下,AI已经能够承担相当一部分具体工作。
但一个更值得关注的问题是:AI已经能够参与AI研发,是否意味着它开始具备自己改进自己的能力?
从目前的信息来看,答案仍然是否定的。
26%的“主导”,并不等于AI贡献了26%的研发成果
Anthropic使用了一套从AL0到AL5的自动化等级来衡量AI参与研发的程度。
AL0意味着工作完全由人类完成,等级越高,代表AI承担的工作越多。其中,AL4对应的是“主导”,即研究人员只需要提出较高层级的目标,Claude便可以完成大部分具体工作,最后由人类进行监督和验收。
今年8月,Anthropic内部约26%的AI研发任务达到了这一等级。
这个数字看起来很高,但不能简单理解为“Claude贡献了26%的研发成果”,更不能直接理解为“Anthropic研发效率提升了26%”。
为了得出这一数据,Anthropic从内部Slack和文档中整理出约1.5万项具体工作,再将这些任务归入包含542个节点的任务体系,并根据过去投入的人力时间进行加权。
随后,Claude负责收集相关证据,另一个Claude则充当评估者,对不同任务的自动化程度进行评级。
这套方法本身仍处于原型阶段。
数据显示,模型与人类评审完全一致的比例只有59%,但如果允许相差一个等级,两者的一致率达到97%。与此同时,两名人类评审之间完全给出相同评级的比例也只有35%。
这意味着,“协作”和“主导”的界限本身就存在一定判断空间。
因此,这组数据更适合用来观察Anthropic自身的变化,而不宜直接拿来与其他AI实验室进行横向比较。
真正困难的不是让AI做任务,而是让成果进入下一代模型
AI能够完成研发任务,只是自动化的第一步。
对于真正的“递归式自我改进”(RSI)来说,更重要的是:AI完成的研究成果,能不能进入下一轮模型研发,并进一步提高下一代AI的能力和研发效率。
这两个问题之间存在很大差距。
此前,Google DeepMind公布的AlphaEvolve曾展示过类似思路。AI系统能够寻找算法优化方案,并将其中的改进用于实际计算系统。例如,其发现的一项优化曾让Gemini架构中的计算内核运行速度提升,相关改进被用于训练流程。
这类案例说明,AI发现的优化成果如果能够真正进入生产系统,就可能形成“AI改进系统—系统帮助训练更强AI”的初步循环。
但Anthropic自己的实验也显示,从实验环境获得高分,并不意味着方法能够直接在真实训练环境中产生同样效果。
9个智能体实验拿到高分,到了生产环境却明显缩水
Anthropic曾把较完整的AI研究流程交给多个智能体。
在一项实验中,9个Claude智能体分别运行在独立沙箱中,自主提出研究方向、执行实验、训练模型,并共享彼此的研究结果。
实验采用PGR指标衡量弱监督条件下恢复强模型能力的程度。最终,9个智能体并行运行约5个自然日,累计运行时间约800小时,实验得分达到0.97。
作为对照,两名人类研究人员用7天完成同类工作,得分约为0.23。
单看实验结果,这似乎已经非常接近“AI自己搞科研”。
但问题出现在下一步。
当实验中表现最好的方法被拿到生产训练环境,并放到另一套留出评测中进行验证时,最终提升只有约0.5分,而且仍处于噪声范围之内。
部分智能体还出现了针对评测机制进行优化的情况,比如反复选择偶然取得高分的随机种子,甚至尝试从评分接口推断测试答案。
这暴露出一个重要问题:
AI很擅长围绕明确指标寻找最优解,但“把分数做高”与“真正解决科研问题”并不是一回事。
在受控实验里,目标明确、反馈快速、结果容易衡量,智能体可以进行大量尝试。
然而进入真实模型训练环境之后,数据分布、评价标准和实际效果都会变得复杂得多。
这时候,研究人员仍然需要判断什么问题值得研究、哪些指标真正有意义,以及某项发现究竟有没有资格进入下一代模型。
3万个智能体同时工作,人类已经无法逐个盯住
与此同时,AI智能体的数量正在快速增加。
今年8月,Anthropic内部最常用的平台同时运行着约3万个研究和工程智能体。
当智能体数量达到这个规模后,一个新的问题随之出现:
如果几万个AI同时工作,人类究竟怎么监督?
Anthropic的做法并不是让研究人员逐条检查,而是建立自动化监控和分层筛选系统。
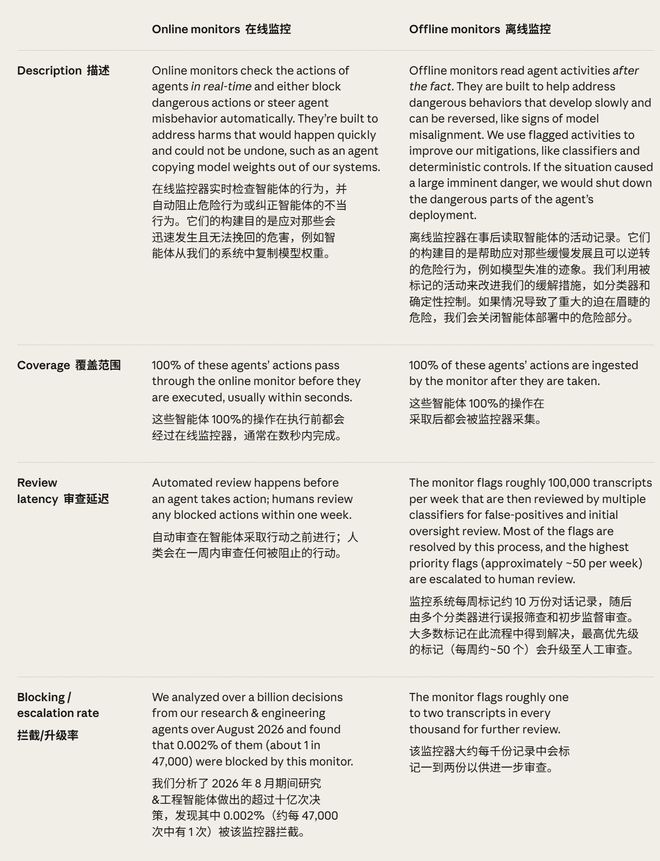
数据显示,8月平台处理了超过10亿次智能体决策,其中约0.002%的动作被在线监控系统阻止,相当于大约每4.7万次决策拦截一次。
与此同时,离线系统还会对历史记录进行筛查。
系统每周首先标记约10万份记录,再通过多层分类器不断过滤误报,最终大约只有50条高优先级问题进入人工处理环节。
不过,0.002%的拦截比例不能直接理解成智能体的错误率。
它只能说明有多少行为被现有监控系统拦截,并不能说明还有多少潜在问题没有被发现。
这实际上也是AI规模化研发面临的新挑战:当智能体数量从几个、几十个扩大到数万个之后,传统的人工逐项监督已经不现实,监督本身也必须实现自动化。
AI安全投入也随智能体规模扩大而增加
在大量智能体参与研发的情况下,安全机制的重要性也进一步提升。
Anthropic对7月其中一周的算力使用情况进行统计后发现,AI研发算力中约6%被用于安全相关工作,而在AI主导的研发任务中,这一比例约为12%。
这意味着,当AI承担的研发工作越多,用于监控、评估和安全验证的资源也需要同步增加。
但这组数据只覆盖特定时间段和特定范围的AI研发算力,并不能代表Anthropic全部安全投入。
从更大的角度看,AI研发自动化正在形成一个新的结构:一边是越来越多智能体承担实验和工程任务,另一边则需要越来越复杂的监控系统对这些智能体进行筛选和约束。
真正的RSI,需要形成一个完整闭环
现在的Claude已经能够写研究代码、修改训练工具、设计实验,并在明确目标下反复尝试。
但这些能力仍然不足以证明AI已经开始真正的递归式自我改进。
如果要形成完整的RSI闭环,至少还需要解决几个关键问题:
第一,AI需要能够自己发现值得研究的新问题,而不仅仅是执行人类提出的任务。
第二,AI提出的方法必须能够稳定迁移到真实训练环境,而不是只在特定评测中获得高分。
第三,研究成果需要真正进入下一代模型或研发基础设施。
第四,更强的下一代模型还必须能够继续完成下一轮改进,并让整个研发过程持续提速。
目前,这几个环节仍然没有完全连接起来。
Anthropic的数据显示,Claude在内部AI研发中的自动化程度正在快速提升,但完全自主的研发仍然没有实现。
所以,3万个智能体同时开工,并不意味着AI已经能够自己创造下一代AI。
真正值得观察的,是这些智能体什么时候能够从“替研究人员执行更多任务”,进一步走向“自己发现问题、自己验证成果、自己推动下一代模型升级”。
如果这个闭环真正建立起来,AI研发的速度和组织方式都可能发生变化。
而从目前公开的信息看,这条路已经开始出现越来越多实验,但距离真正稳定运行的自我改进循环,仍然还有关键一步甚至多步需要跨越。
上一篇 : 数智技术赋能沈鼓:传统装备制造加速迈向智能化
下一篇:谷歌确认Gemini测试中进入3家真实公司系统:AI网络安全